Chatbot RAG : des réponses sourcées, mais pas sans contrôle
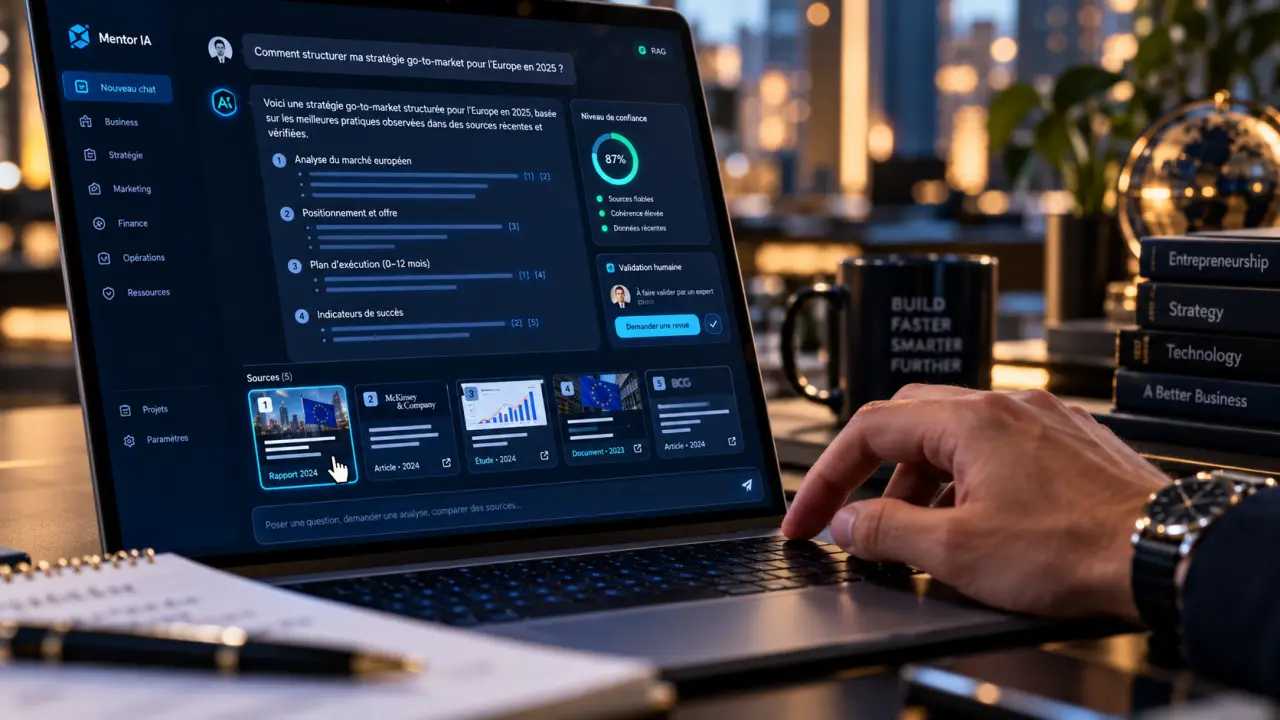
Un chatbot RAG associe un modèle de langage à une recherche dans des sources externes : documents internes, pages web ou base de connaissances. Avant de répondre, il récupère les passages utiles et les transmet au modèle. L’objectif est de produire des réponses adaptées à votre activité, vérifiables et actualisables, sans réentraîner entièrement l’IA. Cette architecture réduit certains risques d’invention, mais sa fiabilité dépend des documents, de la recherche et des contrôles mis en place.
Ce que le RAG change par rapport à un chatbot classique
RAG signifie Retrieval-Augmented Generation, ou génération augmentée par récupération. Le modèle linguistique, appelé LLM, ne s’appuie plus uniquement sur ses connaissances acquises pendant l’entraînement : il reçoit aussi des extraits sélectionnés pour la question posée.
Un assistant RH peut ainsi consulter la politique de congés applicable, tandis qu’un chatbot de support recherche une procédure dans la documentation produit. Les équipes IT, commerciales, juridiques ou financières peuvent utiliser ce principe pour retrouver une information métier. Dans les domaines sensibles, la réponse reste une aide à vérifier, pas une décision autonome.
| Approche | Principe | Usage pertinent | Limite principale |
|---|---|---|---|
| Chatbot à règles | Suit des scénarios et réponses prédéfinis | Parcours simples et stables | Gère mal les questions imprévues |
| LLM généraliste | Répond avec ses connaissances et le contenu transmis | Rédaction, reformulation, explications générales | Ne connaît pas spontanément vos informations internes |
| Chatbot RAG | Recherche des sources avant de générer | Questions sur une documentation métier évolutive | Dépend de la qualité de récupération |
| Fine-tuning, dont LoRA | Adapte les paramètres du modèle par entraînement | Comportement, style ou tâche spécialisée | Ne remplace pas une recherche documentaire actualisée |
RAG et LoRA ne sont donc pas concurrents dans tous les cas : ils peuvent se compléter. Une recherche classique, elle, renvoie surtout des résultats à consulter ; le chatbot RAG ajoute une synthèse conversationnelle, avec le risque supplémentaire de déformer les passages retrouvés.
Du document à la réponse : les mécanismes à comprendre
Préparer une base réellement exploitable
Les PDF, pages web et articles de documentation sont d’abord extraits, nettoyés puis découpés en passages : c’est la segmentation, ou chunking. Chaque passage conserve idéalement son titre, sa provenance, sa date et ses permissions. Trop court, il perd son contexte ; trop long, il peut mélanger plusieurs sujets et encombrer l’invite transmise au modèle.
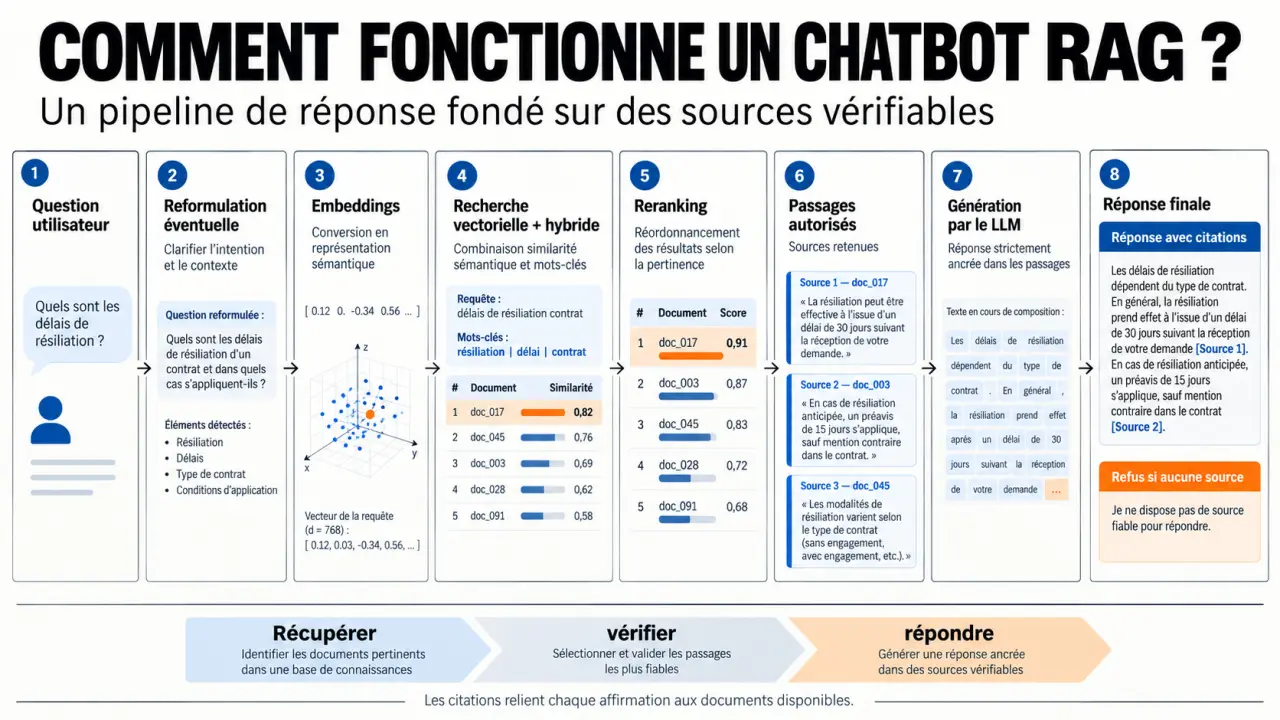
Un modèle d’embeddings transforme ensuite ces passages en vecteurs, des représentations numériques utilisées pour rechercher des proximités de sens. Une base vectorielle stocke et interroge ces représentations. Elle facilite la recherche sémantique, sans constituer une obligation pour toutes les architectures RAG.
Retrouver, sélectionner, puis générer
À chaque question, le système peut reformuler la demande, notamment pour préciser une référence issue de la conversation. Il recherche ensuite les passages pertinents. Une recherche hybride combine proximité sémantique et mots-clés : utile lorsqu’un utilisateur cite une référence produit exacte. Un reclassement, ou reranking, peut affiner la sélection avant génération.
Les extraits retenus sont ajoutés au contexte du LLM avec les instructions de réponse. Le chatbot rédige alors sa synthèse et peut afficher les références des documents ou des pages utilisés. En multilingue, il faut vérifier que les modèles de recherche et de génération gèrent les langues concernées : traduire la question ne garantit pas une récupération correcte.
Le fossé entre le vocabulaire utilisateur et celui des documents mérite une attention particulière. Un salarié demande « travailler ailleurs », alors que la procédure parle de « mobilité géographique ». Consigner ces écarts dans les tests, enrichir les titres et ajouter des synonymes métier aide à retrouver le bon texte. Une recherche infructueuse ne signifie pas forcément que l’information manque : elle peut révéler une rupture de vocabulaire.
Construire un premier chatbot sans surdimensionner le projet
Commencez par un périmètre précis, comme l’assistance sur un produit ou une procédure interne. Un corpus restreint, validé par un responsable métier, permet de repérer les erreurs plus facilement qu’une importation massive de documents hétérogènes.
- Définir le service attendu : utilisateurs, questions couvertes, ton, identité de l’assistant et situations nécessitant un transfert humain.
- Sélectionner les sources : documents, URL, wiki ou API. Pour des données changeantes, distinguer les contenus indexés des informations interrogées en temps réel.
- Préparer l’index : retirer les doublons, conserver les titres, segmenter et associer les métadonnées utiles.
- Configurer les instructions : répondre à partir des extraits autorisés, citer les passages et signaler les informations manquantes.
- Tester les conversations : questions réelles, demandes ambiguës, documents contradictoires et tentatives d’accès non autorisé.
- Publier progressivement : ouvrir un webchat à un groupe pilote, puis élargir après correction des défauts observés.
Pour choisir un outil, comparez les connecteurs, les permissions documentaires, les citations, les possibilités d’export et la visibilité sur les erreurs. Botpress Studio propose une approche de création de chatbots et revendique plus de 750000 chatbots déployés. Ce volume ne constitue toutefois pas une mesure de précision pour votre projet.
Une solution gérée, telle que l’offre d’automatisation du RAG présentée par Cloudflare, peut simplifier l’indexation et la synchronisation. Une architecture sur mesure donne davantage de contrôle, mais demande de maintenir les connecteurs, la recherche et le déploiement. Aucun choix ne dispense de tester vos propres documents.
Sécuriser les sources et savoir ne pas répondre
Les droits d’accès doivent être appliqués pendant la récupération, avant que les passages ne soient transmis au modèle. Masquer une information seulement dans l’interface ne suffit pas. L’identité de l’utilisateur doit déterminer les documents accessibles, selon le principe du moindre privilège.
La consigne « pas de source, pas de réponse » fournit une règle de comportement utile, sans garantir à elle seule l’absence d’hallucinations. Si aucune procédure autorisée ne répond à la question, l’assistant doit l’indiquer et proposer une orientation pertinente. Si deux documents se contredisent, il doit signaler le conflit plutôt que fabriquer une conciliation.
Les citations nécessitent également un contrôle : le passage cité doit réellement soutenir l’affirmation. Un document récupéré reste une donnée, pas une instruction à exécuter ; son contenu ne doit pas pouvoir modifier les règles de sécurité du chatbot.
Enfin, vérifiez l’hébergement, la conservation des conversations et les conditions de traitement des données par les prestataires. La suppression d’un fichier ou la modification d’une permission doit être répercutée dans l’index et les éventuels caches. Les journaux de diagnostic doivent eux aussi éviter d’exposer des informations sensibles.
Évaluer la qualité avant et après la mise en ligne
Constituez un jeu de questions représentatives avec les réponses attendues et les passages justificatifs, validés par un expert métier. Incluez des formulations approximatives, des questions sans réponse, plusieurs langues si nécessaire et des profils disposant de droits différents.
- Récupération : le système retrouve-t-il les passages nécessaires, sans accumuler des extraits inutiles ?
- Fidélité : chaque affirmation importante est-elle soutenue par les documents récupérés ?
- Utilité : la réponse résout-elle la demande, avec des citations vérifiables ?
- Abstention et sécurité : l’assistant reconnaît-il les informations absentes et respecte-t-il les permissions ?
- Exploitation : quels sont le temps de réponse, le coût par échange et la satisfaction utilisateur ?
Séparer recherche et génération permet de corriger le bon composant : un excellent modèle ne compense pas un passage essentiel introuvable. Surveillez aussi le coût des embeddings, du stockage, du reclassement et des tokens transmis. Ajouter davantage de contexte peut augmenter le coût et la latence sans améliorer la réponse.
Après publication, attribuez un responsable à chaque corpus, actualisez l’index et rejouez les tests lors des changements importants. Un chatbot RAG fiable est un service documentaire entretenu, pas simplement un modèle connecté une fois à des fichiers.